اجرای هوش مصنوعی روی کامپیوتر خودتان دیگر کار متخصصها نیست. Ollama برنامهای رایگان و متنباز است که مدلهای زبانی متنباز مثل Gemma، Qwen و gpt-oss را دانلود و روی سختافزار خودتان اجرا میکند. بعد از دانلود مدل، گفتگو به اینترنت نیازی ندارد و هیچ متنی از کامپیوترتان خارج نمیشود؛ مناسب کارهای محرمانه، شبکههای بدون اینترنت و برنامهنویسهایی که میخواهند هوش مصنوعی را در نرمافزار خودشان بگذارند.
نصب Ollama
- ویندوز و macOS: فایل نصب را از ollama.com/download بگیرید و اجرا کنید. از نسخهٔ تابستان ۲۰۲۵، Ollama پنجرهٔ گفتگوی گرافیکی هم دارد که مدل را از آن انتخاب میکنید و میتوانید فایل PDF یا متنی را برای خلاصه کردن رویش بکشید.
- لینوکس: با دستور زیر نصب کنید؛ Ollama بهصورت یک سرویس systemd نصب و اجرا میشود.
curl -fsSL https://ollama.com/install.sh | shبرای اطمینان از نصب، در Terminal بزنید:
ollama --versionاجرای اولین مدل
با یک دستور، مدل دانلود و گفتگو شروع میشود:
ollama run gemma3بار اول چند گیگابایت دانلود میشود. بعد از آن پیامتان را بنویسید و Enter بزنید؛ برای خروج /bye را بنویسید. gemma3 بدون برچسب، نسخهٔ 4b را دانلود میکند که روی بیشتر کامپیوترها اجرا میشود و تصویر هم میفهمد.
انتخاب مدل مناسب کارت گرافیک
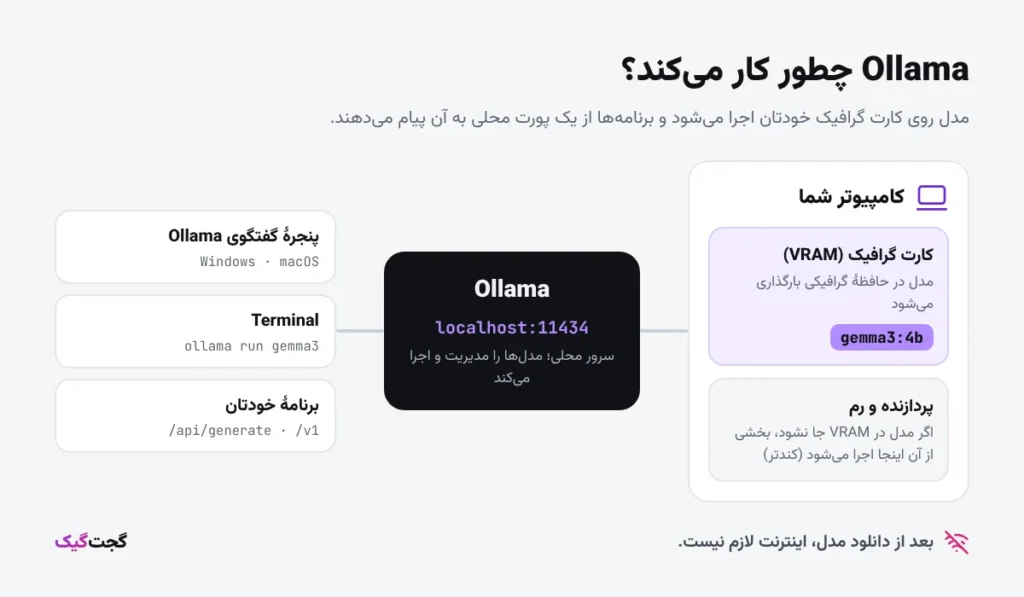
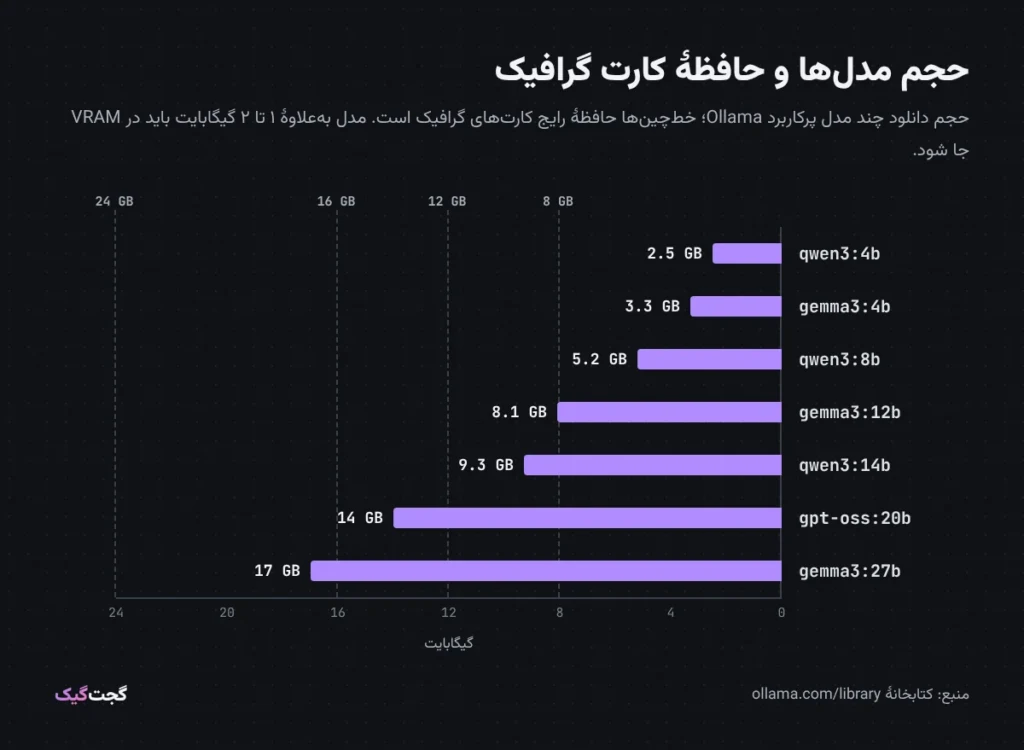
مهمترین عامل سرعت این است که مدل کامل در حافظهٔ کارت گرافیک (VRAM) جا شود. قاعدهٔ ساده: حجم دانلود مدل بهعلاوهٔ ۱ تا ۲ گیگابایت برای متن گفتگو باید از VRAM کمتر باشد. اگر جا نشود، Ollama بخشی از مدل را روی پردازنده و رم اجرا میکند که چند برابر کندتر است.
| مدل | حجم دانلود | مناسب برای |
|---|---|---|
qwen3:4b | 2.5 GB | لپتاپ و کارت گرافیک ۴ تا ۶ گیگابایتی |
gemma3:4b | 3.3 GB | کار روزمره؛ تصویر هم میفهمد |
qwen3:8b | 5.2 GB | کارت گرافیک ۸ گیگابایتی |
gemma3:12b | 8.1 GB | کارت گرافیک ۱۲ گیگابایتی |
qwen3:14b | 9.3 GB | کارت گرافیک ۱۲ تا ۱۶ گیگابایتی |
gpt-oss:20b | 14 GB | کارت گرافیک ۱۶ گیگابایتی |
gemma3:27b | 17 GB | کارت گرافیک ۲۴ گیگابایتی |
روی مکهای Apple Silicon، حافظهٔ یکپارچه (Unified Memory) نقش VRAM را دارد. مدلهای تازه مرتب به کتابخانه اضافه میشوند؛ فهرست کامل را در ollama.com/library ببینید.
دستورهای کاربردی Ollama
ollama pull qwen3:8b
ollama list
ollama ps
ollama stop gemma3
ollama rm gemma3pullمدل را بدون شروع گفتگو دانلود میکند.listمدلهای دانلودشده و حجمشان را نشان میدهد.psمدلهای در حال اجرا را نشان میدهد؛ اگر ستونPROCESSORچیزی غیر از100% GPUنوشت، مدل کامل در VRAM جا نشده است.stopمدل را از حافظه خارج میکند وrmآن را از دیسک پاک میکند.
اتصال برنامهها به Ollama
Ollama یک سرور محلی روی پورت 11434 اجرا میکند و هر برنامهای میتواند از طریق API به آن پیام بفرستد. برای آزمایش در PowerShell:
(Invoke-RestMethod -Uri "http://localhost:11434/api/generate" -Method Post -ContentType "application/json" -Body '{"model":"gemma3","prompt":"Explain DNS in one sentence","stream":false}').responseOllama یک API سازگار با OpenAI هم در آدرس http://localhost:11434/v1 دارد؛ بنابراین بسیاری از برنامهها و کتابخانههایی که برای ChatGPT نوشته شدهاند، فقط با تغییر آدرس به Ollama وصل میشوند.
استفاده از Ollama در شبکهٔ داخلی
Ollama بهطور پیشفرض فقط به درخواستهای خود کامپیوتر جواب میدهد (127.0.0.1). برای اینکه کامپیوترهای دیگر شبکه هم از آن استفاده کنند، متغیر محیطی OLLAMA_HOST را روی 0.0.0.0 بگذارید. در ویندوز:
setx OLLAMA_HOST "0.0.0.0"بعد Ollama را از آیکون کنار ساعت ببندید (Quit Ollama) و دوباره باز کنید. در لینوکس، sudo systemctl edit ollama.service را بزنید، زیر [Service] خط Environment="OLLAMA_HOST=0.0.0.0" را اضافه کنید و سرویس را دوباره راهاندازی کنید:
sudo systemctl daemon-reload
sudo systemctl restart ollama
sudo ufw allow from 192.168.1.0/24 to any port 11434 proto tcp
دستور آخر پورت Ollama را فقط برای شبکهٔ داخلی 192.168.1.x باز میکند؛ بازهٔ IP شبکهٔ خودتان را جایگزین کنید.
Ollama رمز عبور ندارد. هر کسی که به پورت 11434 دسترسی داشته باشد، میتواند از مدلها استفاده کند. این پورت را هرگز روی اینترنت باز نکنید؛ روش محدود کردن دسترسی در آموزش فایروال UFW در اوبونتو آمده است.
آموزشهای بیشتر دربارهٔ ابزارهای هوش مصنوعی را در دستهٔ هوش مصنوعی و راهنمای مدیریت سرور را در دستهٔ لینوکس ببینید.
سؤالات متداول
Ollama بدون کارت گرافیک کار میکند؟
بله، روی پردازنده هم اجرا میشود اما کندتر. مدلهای کوچک مثل qwen3:4b یا gemma3:1b روی لپتاپهای معمولی هم قابل استفادهاند.
Ollama رایگان است؟
بله؛ خود برنامه متنباز و رایگان است و مدلها هم رایگان دانلود میشوند. هر مدل مجوز خودش را دارد؛ پیش از استفادهٔ تجاری آن را بررسی کنید.
مدلهای محلی به خوبی ChatGPT یا Claude هستند؟
برای کارهای روزمره مثل خلاصهنویسی، ترجمه و پاسخ به سؤالهای ساده، مدلهای ۸ تا ۱۴ میلیارد پارامتری نتیجهٔ خوبی میدهند، اما در استدلال پیچیده و برنامهنویسی سنگین، مدلهای ابری بزرگ هنوز جلوترند.
مدلها فارسی بلدند؟
بیشتر مدلهای جدید مثل Gemma 3 و Qwen3 فارسی را میفهمند و مینویسند؛ کیفیت فارسی در نسخههای بزرگتر بهتر است.
مدلها کجا ذخیره میشوند؟
در ویندوز در C:\Users\YourName\.ollama\models، در لینوکس (نصب با اسکریپت رسمی) در /usr/share/ollama/.ollama/models و در macOS در ~/.ollama/models. با متغیر OLLAMA_MODELS میتوانید این مسیر را عوض کنید.
منابع
- Ollama FAQ — مستندات رسمی Ollama
- OpenAI compatibility — مستندات رسمی Ollama
پرسش یا دیدگاهی دارید؟